Uma janela de contexto maior melhora a capacidade de leitura imediata, mas não resolve, por si só, o problema da continuidade temporal. A distinção parece simples até o momento em que um sistema precisa lembrar preferências, manter estado entre sessões, recuperar decisões anteriores ou atualizar um fato sem reescrever todo o passado.
Nesse ponto, a linguagem comum começa a atrapalhar. Chama-se tudo de “memória”, como se aumentar o número de tokens disponíveis bastasse para produzir comportamento durável. Não basta.
Contexto é a superfície de trabalho do modelo durante uma inferência específica. Memória persistente é outra classe de mecanismo: precisa conservar, atualizar e recuperar informações ao longo do tempo. Estado operacional é aquilo que orienta uma execução em andamento. Histórico episódico é o registro do que aconteceu, mas não deve ser confundido com conhecimento consolidado.
Misturar essas camadas produz sistemas que parecem lembrar, quando na realidade apenas continuam carregando uma quantidade cada vez maior de passado para dentro do presente.
O modelo só pode raciocinar sobre aquilo que está disponível na inferência atual. A atenção estabelece relações entre os tokens presentes naquela chamada, mas não cria, por si só, continuidade entre sessões.
O KV-cache melhora essa situação dentro de uma trajetória de inferência, evitando que determinados estados já calculados precisem ser reconstruídos a cada novo token. É uma otimização importante para eficiência, mas não constitui memória persistente. Quando aquela trajetória termina, o cache não se transforma automaticamente em conhecimento durável que possa ser consultado em uma interação futura.
É por isso que ampliar o contexto e criar memória são problemas arquiteturalmente diferentes. O primeiro aumenta a quantidade de informação que pode estar disponível em uma determinada inferência. O segundo exige mecanismos para armazenar, selecionar, atualizar e recuperar informação ao longo do tempo.
Existe ainda um custo prático. Contextos maiores significam mais dados para processar, transportar ou considerar durante a inferência, o que pode aumentar latência e custo. Em sistemas agênticos, esse efeito é especialmente relevante porque uma única execução raramente contém apenas uma chamada ao modelo. O custo de carregar repetidamente o mesmo histórico pode se acumular ao longo de dezenas ou centenas de etapas.
Existe uma diferença fundamental entre registrar eventos e manter conhecimento útil.
Um log episódico deve preservar o que aconteceu. Por isso, faz sentido que seja append-only e imutável: comandos, respostas, decisões, falhas e alterações precisam permanecer disponíveis para auditoria e reconstrução do passado.
Memória semântica tem outra função. Ela representa aquilo que, depois de consolidado, deve orientar operações futuras. Uma preferência pode mudar. Uma política pode ser atualizada. Um fato anteriormente considerado válido pode ser substituído. Nesse caso, a memória precisa admitir atualização controlada, idealmente com versionamento e rastreabilidade.
O log responde à pergunta “o que aconteceu?”.
A memória consolidada responde a uma pergunta diferente: “o que devemos considerar válido ou relevante agora?”
Essa separação é importante porque sistemas agênticos tomam decisões em cadeia. Se tudo permanece como histórico bruto, o sistema acumula informação sem necessariamente saber qual estado deve prevalecer. Se tudo é tratado como informação editável, perde-se a trilha que explica como aquele estado foi produzido.
Memória não é simplesmente armazenar mais. É estabelecer uma relação governada entre passado, presente e estado atual.
O estudo de Liu et al. conhecido como Lost in the Middle tornou esse problema particularmente evidente. Em tarefas de pergunta e resposta envolvendo múltiplos documentos, os autores observaram que o desempenho dos modelos pode cair quando a informação relevante está posicionada no meio de um contexto extenso.
O resultado não significa que contextos longos sejam inúteis. Tampouco demonstra que uma determinada arquitetura de memória seja necessária para toda aplicação. A conclusão mais importante é mais específica: a presença de uma informação dentro da janela não garante que ela será utilizada com a mesma eficácia em qualquer posição ou configuração contextual.
Essa diferença é crucial.
Uma janela de milhões de tokens pode conter a informação correta e, ainda assim, apresentar dificuldades para recuperá-la ou atribuir-lhe a prioridade adequada. O problema deixa de ser apenas capacidade de armazenamento e passa a envolver seleção, relevância e organização.
Em outras palavras, aumentar a janela resolve parcialmente o problema de quanto pode ser carregado. Não resolve automaticamente o problema de o que deveria ser lembrado.
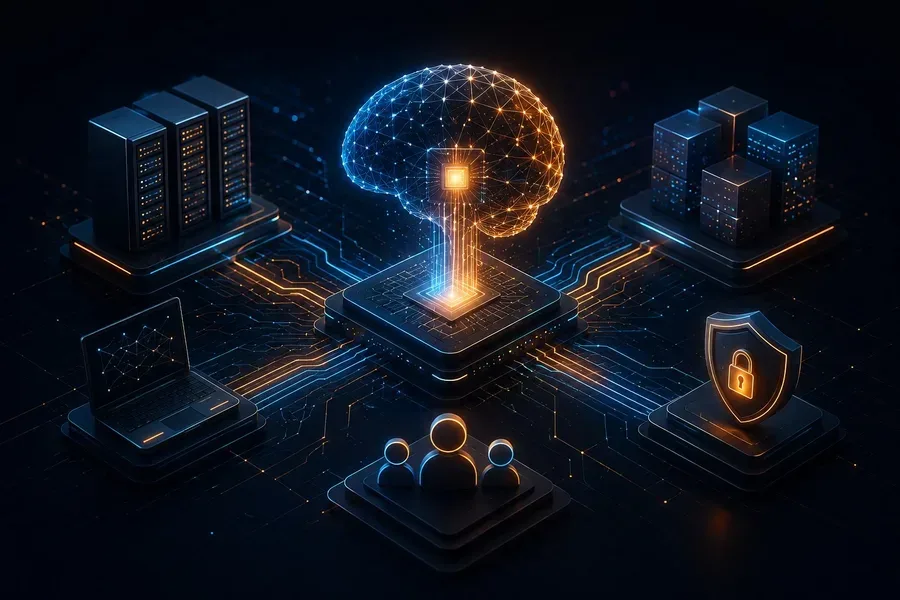
Uma arquitetura de memória persistente pode separar pelo menos três funções distintas.
A primeira é o contexto de trabalho, responsável pelas informações necessárias para a execução corrente. Ele deve ser pequeno o suficiente para permanecer operacional e conter apenas aquilo que realmente influencia a tarefa em andamento.
A segunda é o log episódico, que preserva os eventos ocorridos ao longo do tempo. Sua função principal é rastreabilidade, não eficiência de inferência.
A terceira é a memória semântica, na qual informações relevantes são consolidadas para recuperação futura. É essa camada que permite transformar uma sequência de eventos em conhecimento operacional.
O benefício dessa separação não está apenas na redução do número de tokens enviados ao modelo. O ganho mais importante é arquitetural: o sistema passa a representar o tempo de maneira explícita.
Um evento pode permanecer intacto no histórico enquanto uma informação derivada dele é atualizada na memória semântica. Uma preferência pode ser alterada sem apagar as interações que explicam sua origem. Um estado pode ser invalidado sem destruir a evidência de que ele existiu.
Isso transforma memória de um simples depósito de texto em um mecanismo de governança do estado.
Isso não significa que adicionar uma camada de memória resolva automaticamente os problemas de um agente. Apenas muda onde eles aparecem.
Um mecanismo de retrieval pode recuperar a informação errada ou deixar de recuperar uma informação relevante. Chunking pode separar elementos que deveriam permanecer juntos. Embeddings podem aproximar conteúdos semanticamente semelhantes, mas operacionalmente diferentes. Rerankers acrescentam processamento e latência. Dados antigos podem permanecer disponíveis mesmo depois de perderem validade.
Existe ainda um risco mais sutil: uma memória mal estruturada pode aumentar a confiança de uma resposta errada.
Um modelo sem memória pode inventar porque não possui informação suficiente. Um modelo conectado a uma memória ruim pode produzir uma resposta igualmente incorreta, mas agora sustentada por fragmentos que aparentam ser evidência.
Por isso, grounding não significa simplesmente recuperar documentos. Significa estabelecer uma relação confiável entre fonte, relevância, versão e estado atual.
Seria um erro transformar a discussão em uma oposição simplista entre contexto longo e memória externa.
Existem tarefas em que uma janela ampla é precisamente a solução mais adequada. Uma auditoria pontual de um repositório fechado, a revisão integral de um documento extenso ou a análise de uma sessão que não precisa sobreviver à própria execução podem se beneficiar enormemente da disponibilidade de todo o material em uma única inferência.
Nesses casos, introduzir uma arquitetura de memória pode simplesmente acrescentar complexidade, latência e novos pontos de falha.
O problema surge quando a mesma estratégia é aplicada a sistemas que precisam atravessar o tempo.
Se existem múltiplas sessões, atualização de conhecimento, estados concorrentes, decisões anteriores que precisam ser recuperadas ou informações que deixam de ser válidas, simplesmente aumentar a janela começa a parecer menos uma arquitetura de memória e mais um mecanismo de transporte de histórico.
A pergunta mais útil para projetar um sistema agêntico não é quantos tokens sua janela suporta.
É qual camada deve carregar cada tipo de informação.
Contexto ampliado é apropriado quando a tarefa cabe em uma leitura única e verificável. Memória persistente se torna necessária quando existe continuidade entre interações, atualização de estado, versionamento ou recuperação seletiva. O histórico episódico deve preservar a rastreabilidade. A memória consolidada deve representar aquilo que o sistema considera operacionalmente válido. E o mecanismo de recuperação precisa ser tratado como parte central da arquitetura, não como um detalhe de implementação.
A diferença fundamental é esta: contexto longo amplia o presente; memória persistente conecta o presente ao tempo.
Sistemas agênticos não precisam necessariamente de janelas cada vez maiores. Precisam saber o que aconteceu, o que continua válido e o que realmente precisa ser trazido para a execução atual.
É essa separação que transforma memória de uma acumulação de tokens em uma propriedade arquitetural do sistema.